La caída de Microsoft 365 y el riesgo de que una alerta dependa de un solo canal
Qué pasó en la caída global de Microsoft 365 de noviembre de 2026, cómo un aviso por correo que nunca llegó terminó con quince personas atendidas en la piscina de un hotel, y cómo diseñar alertas que no dependan de un único punto.
Por Javier Tenjo, Desarrollador full stack
En esta página
- ¿Qué pasó con Microsoft 365 en noviembre de 2026?
- ¿Qué tiene que ver una piscina con el correo de Outlook?
- ¿Qué es un punto único de fallo?
- ¿Por qué el correo es un mal canal para una alarma crítica?
- ¿Cómo se diseña un aviso que no dependa de un solo punto?
- ¿Qué riesgo hay en automatizar a medias?
- ¿Por dónde empezar a revisar tus propios avisos?
- En resumen
Un sistema de control detecta que hay demasiado cloro en una piscina. Hace lo que tiene que hacer: envía una alerta. La alerta sale por correo electrónico, el correo depende de Microsoft 365 y Microsoft 365 lleva casi un día caído. Nadie la lee. Un rato después, quince huéspedes de un hotel tienen irritación en las vías respiratorias y hay bomberos y ambulancias en la puerta.
Es lo que pasó a mediados de noviembre de 2026 en el hotel Ling Bao del parque Phantasialand, en Brühl (Alemania). La caída de Microsoft no causó la avería, pero apagó el único aviso que había. Y ese detalle, más que la caída en sí, es lo que vale la pena entender si en tu empresa algún proceso importante depende de que llegue un mensaje.
¿Qué pasó con Microsoft 365 en noviembre de 2026?
La interrupción empezó el 12 de noviembre, hacia las 18:00 UTC, y se prolongó más de 48 horas. Según la cronología que recoge Wikipedia, afectó sobre todo a Outlook, Exchange Online y Teams, también a Copilot, y llegó a usuarios de más de setenta países. The Register informó de que se cayeron incluso las consolas de administración, como Intune, lo que dejó a los equipos de TI con menos herramientas justo cuando más las necesitaban.
Las consecuencias fueron mucho más allá del correo de oficina. En el Reino Unido, hospitales del sistema público cancelaron algunas operaciones y hubo problemas con las recetas electrónicas; en Brasil, el Supremo Tribunal Federal suspendió el cómputo de plazos judiciales durante dos días; en Canadá, una red hospitalaria declaró código gris. En Colombia, el Consejo Superior de la Judicatura suspendió los términos judiciales en todos los despachos del país a partir del 13 de noviembre, porque las audiencias y los trámites dependían de Outlook y Teams, y los reanudó el 17, cuando Microsoft restableció el servicio.
Microsoft descartó un ciberataque. Atribuyó la falla a un error en su propia infraestructura de red que un cambio posterior de configuración terminó de activar, y que hacía que los servidores se saturaran y dejaran de responder. El servicio se fue restableciendo de forma gradual hasta el 14 de noviembre.
¿Qué tiene que ver una piscina con el correo de Outlook?
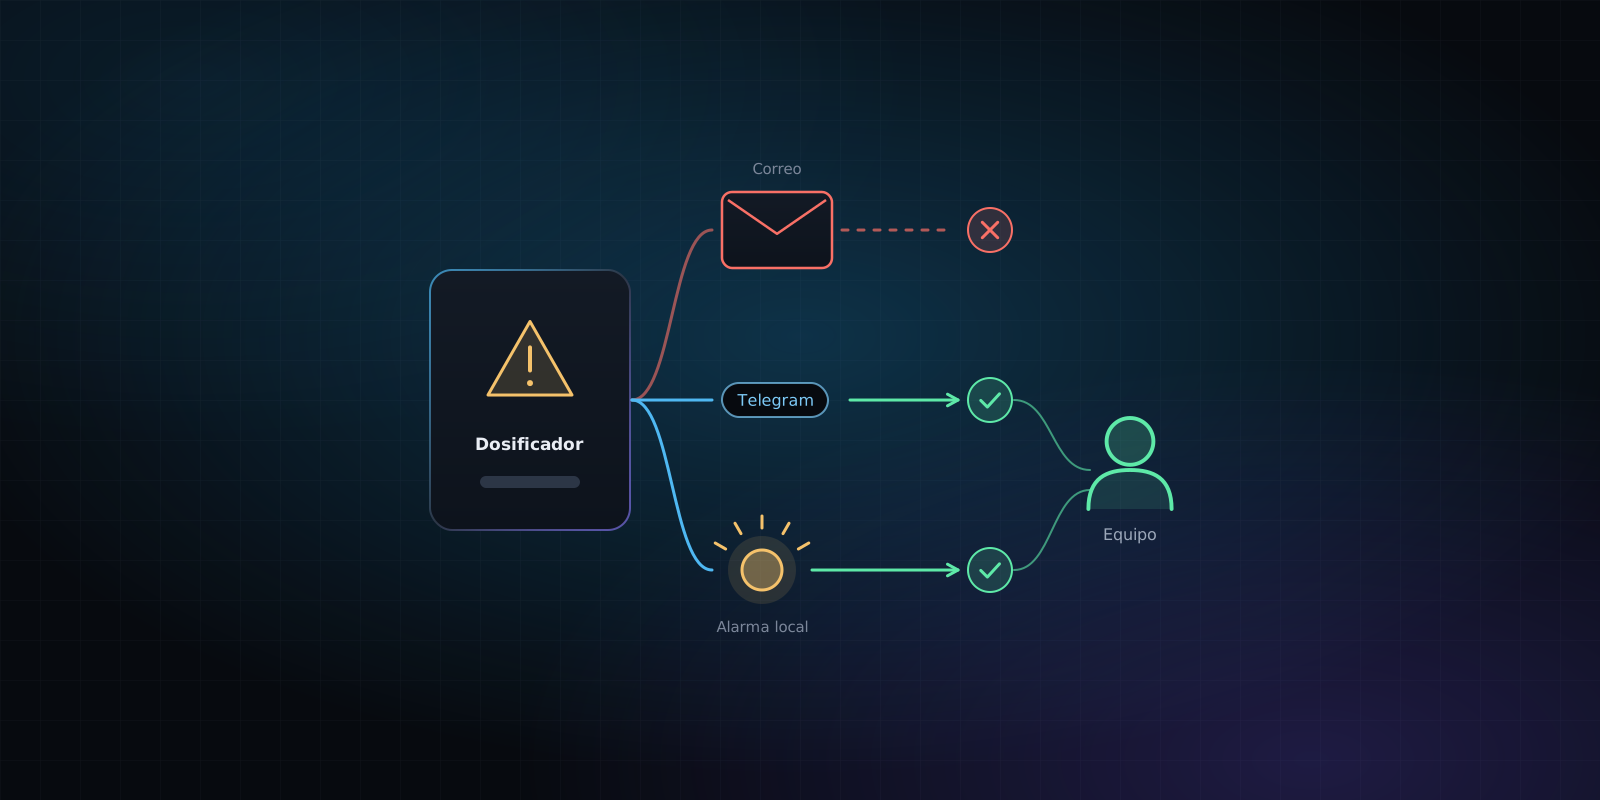
Según contó la cadena pública alemana WDR, el sistema automático de dosificación de la piscina del hotel falló y bombeó demasiado cloro al agua. El sistema de seguridad de la zona de spa detectó el problema y envió la alarma por correo. Por la caída de Microsoft, ese correo no llegó, y nadie se enteró a tiempo.
Trece huéspedes se quejaron primero de irritación respiratoria, y la cifra subió después a quince. Cuatro personas fueron trasladadas al hospital y una quedó en observación con lesiones de gravedad media. Los bomberos confirmaron la avería de la dosificación, la piscina se cerró, se cambió el agua y después volvió a abrir. The Register añade que el operativo movilizó a unas cuarenta personas durante cerca de dos horas.
Lo interesante es dónde pone la responsabilidad un especialista consultado por la WDR, el arquitecto de ciberseguridad Stephan Skrobisch: no en Microsoft, sino en cómo se montó la instalación. A su juicio, faltó un segundo mecanismo de aviso, por ejemplo una señal acústica, porque un sistema que debe proteger a personas no puede depender solo de un buzón de correo.
En el mismo reportaje, el responsable técnico de otro balneario de la región explicaba cómo lo resuelven ellos: miden el agua tres veces al día y, si el cloro se sale del rango, se enciende una luz roja que ve todo el mundo. No es un sistema sofisticado. Es un sistema que no depende de nadie más.
¿Qué es un punto único de fallo?
Un punto único de fallo es cualquier pieza de un proceso que, si se cae, se lleva el proceso entero por delante. No hace falta que sea un servidor: puede ser un proveedor, una contraseña que solo conoce una persona, una integración o, como aquí, el canal por el que viaja un aviso.
En el caso del hotel, casi todo funcionó. El sensor midió, el sistema detectó el valor anómalo y la alerta se generó. Falló un único eslabón, la entrega, y como no había otro camino, el resultado fue el mismo que si no hubiera habido ningún sistema.
Hay un matiz que lo hace todavía más delicado: un aviso que no llega no hace ruido. Si el correo falla, nadie recibe un mensaje que diga «el correo está fallando». El silencio se interpreta como que todo va bien, y es justo lo contrario.
¿Por qué el correo es un mal canal para una alarma crítica?
El correo electrónico es estupendo para lo que no corre prisa. Para una alarma tiene varios problemas a la vez:
- No garantiza tiempos. Un mensaje puede tardar segundos u horas, y el protocolo da por buena cualquiera de las dos.
- Compite con todo lo demás. Una alerta en la bandeja de entrada está entre boletines, facturas y respuestas automáticas. Si además una regla o un filtro la manda a otra carpeta, desaparece.
- No pide confirmación. El sistema que envía no sabe si alguien la leyó, así que no puede insistir ni avisar a otra persona.
- Depende de terceros. De tu proveedor de correo, del del destinatario, de los filtros antispam y de la conexión del móvil de quien la recibe. Basta con que uno falle.
Nada de esto hace que el correo sea inútil. Sirve muy bien como registro y como canal secundario. El problema es que sea el único.
¿Cómo se diseña un aviso que no dependa de un solo punto?
La idea de fondo es que cada aviso importante tenga al menos dos caminos que no compartan el mismo punto débil. En la práctica se traduce en unas pocas decisiones:
Canales de proveedores distintos
Correo y Teams son dos canales, pero los dos son Microsoft: en noviembre se cayeron juntos. La redundancia real combina canales que no dependen del mismo proveedor, por ejemplo correo más un mensaje por Telegram, un SMS o una llamada automática. Para lo verdaderamente crítico, también una señal local en el sitio (una luz, una sirena, un panel), que funciona aunque no haya internet.
Confirmación y escalado
Un buen sistema de alertas no se limita a enviar: espera a que alguien confirme que lo vio. Si en cinco o diez minutos nadie responde, avisa a la siguiente persona de la lista, y luego a la siguiente. Así una alerta no se queda dormida en el móvil de alguien que está de vacaciones o sin cobertura.
Que el silencio también sea una alarma
Es lo que en el oficio se llama latido o heartbeat: el sistema envía cada cierto tiempo un «sigo vivo», y es otro sistema, independiente, el que da la voz de alarma si ese mensaje deja de llegar. De este modo se detecta también lo que el caso del hotel no podía detectar: que el propio canal de avisos se ha caído.
Una acción automática segura
Cuando hay personas en riesgo, no basta con avisar. Si un valor se sale del rango, el sistema puede tomar la acción segura por sí solo (detener la dosificación, cerrar una válvula, cortar un proceso) y avisar después. La persona entra para resolver, no para evitar el accidente.
Controles que no desaparecen
Automatizar no debería eliminar las comprobaciones manuales de lo crítico. La medición tres veces al día del balneario vecino es poco glamurosa, pero es una segunda capa que no depende de ninguna nube.
Probarlo de verdad
Un plan de alertas que nunca se ha probado es una suposición. Conviene simular de vez en cuando la caída de cada canal (desconectar el correo, apagar el servidor de mensajería) y comprobar que el aviso llega igualmente por el otro camino.
¿Qué riesgo hay en automatizar a medias?
La automatización bien hecha quita trabajo y reduce errores. La automatización a medias hace algo más peligroso: da una sensación de control que no se corresponde con la realidad. Cuando existe un sistema que «avisa si pasa algo», la gente deja de mirar, y es razonable que lo haga. El problema aparece el día que el sistema no avisa y nadie lo sabe.
Tampoco ayuda pensar que la nube no falla. Los grandes proveedores tienen una disponibilidad altísima, pero no perfecta, y su contrato cubre su servicio, no tu proceso. Si una caída de dos días de tu proveedor de correo deja ciego un proceso de seguridad, ese riesgo es tuyo, no suyo. Por eso, al automatizar, la pregunta útil no es «¿funciona?», sino «¿qué pasa cuando falla cada una de sus piezas?».
¿Por dónde empezar a revisar tus propios avisos?
No hace falta rediseñarlo todo. Basta con hacer una lista de los avisos que importan de verdad (seguridad de personas, pagos, pedidos, caídas de la web, copias de seguridad) y contestar cinco preguntas para cada uno:
- ¿Por qué canal sale y de qué proveedor depende?
- ¿Hay un segundo canal que no dependa del mismo proveedor?
- ¿Alguien tiene que confirmar que lo recibió? ¿Qué pasa si no confirma?
- ¿Me enteraría si el aviso dejara de funcionar?
- ¿Cuándo fue la última vez que lo probamos?
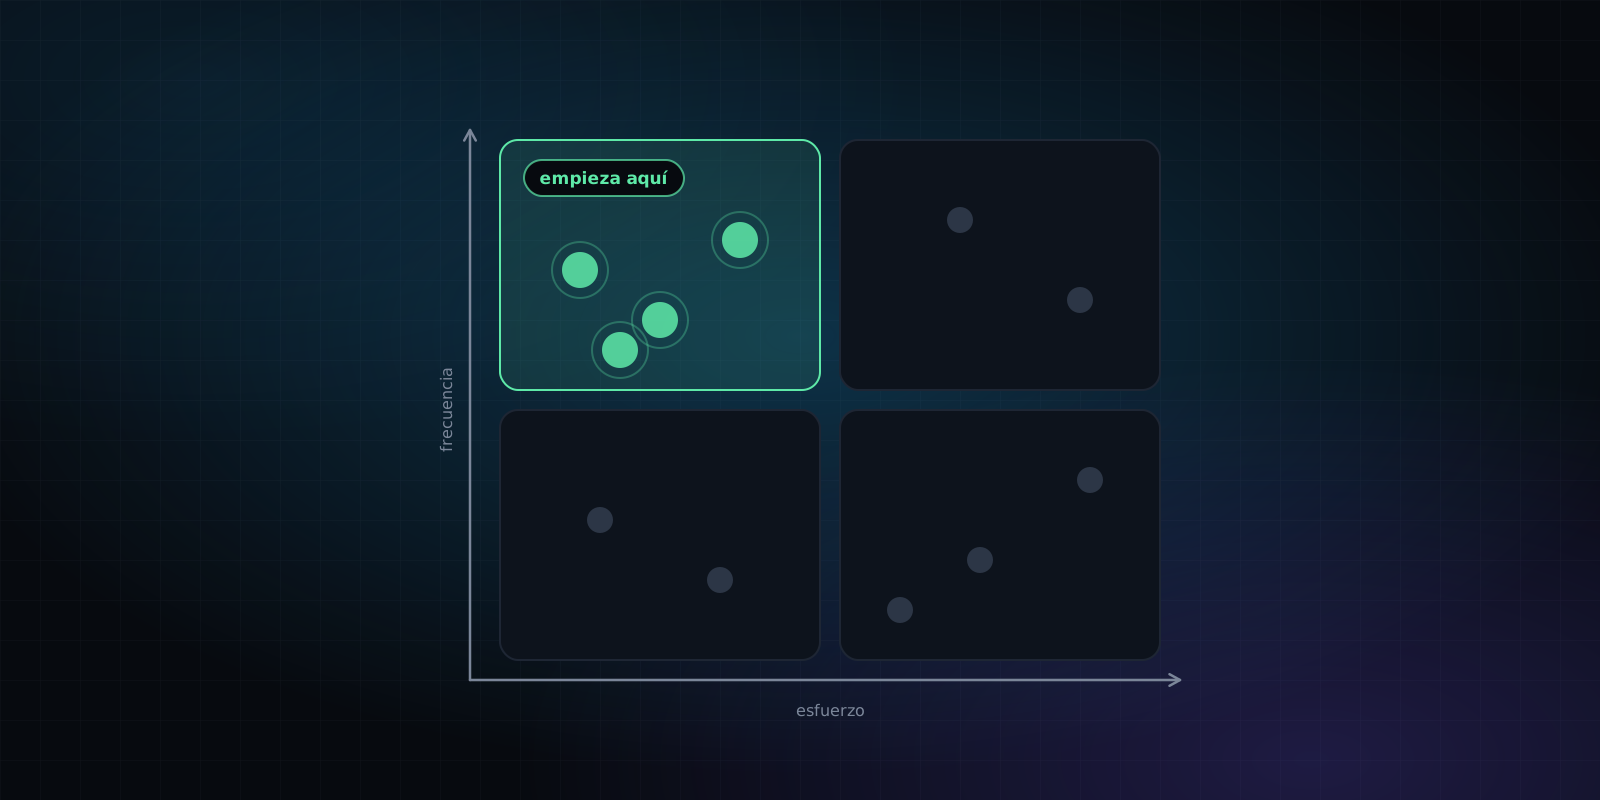
Las respuestas suelen dejar claro por dónde empezar, igual que pasa al decidir qué automatizar primero: primero lo que más daño hace si falla, después lo demás. Es el tipo de trabajo que hacemos en orquestación de procesos, donde cada flujo se diseña con registro de lo que pasó y con un plan para cuando algo falla.
En resumen
La caída de Microsoft 365 de noviembre de 2026 fue un problema del proveedor. Lo que ocurrió en la piscina del hotel fue, sobre todo, un problema de diseño: un aviso crítico con un solo camino. Ningún proveedor va a estar disponible siempre, así que la solución no pasa por elegir el proveedor perfecto, sino por que ningún aviso importante dependa de uno solo. Dos canales independientes, confirmación, una alarma para el silencio y una acción segura automática cubren la mayoría de los casos, y cuestan bastante menos que el día en que hacen falta.